

multabase.com: Eine Datenbank der DSGVO-Bußgelder, in der jede Zahl einen Beleg hat
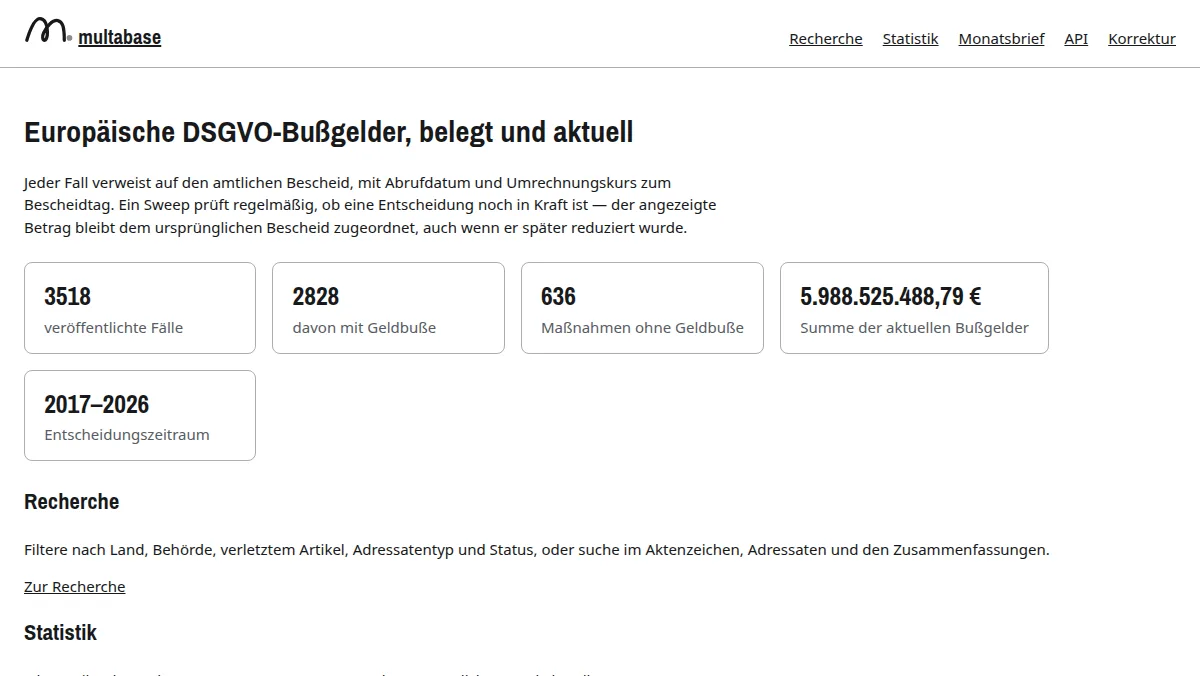
Über DSGVO-Bußgelder wird viel geschrieben und wenig belegt. In Vorträgen und Angebotsschreiben tauchen Summen auf, deren Herkunft niemand mehr nachvollziehen kann, und nicht selten stammt die Zahl aus einem Bescheid, den ein Gericht längst gekürzt oder aufgehoben hat. Wer wissen will, was ein bestimmter Verstoß in der Praxis kostet, braucht zwei Dinge: den amtlichen Beleg und den heutigen Stand des Verfahrens. Genau dafür ist multabase.com entstanden – eine Datenbank europäischer DSGVO-Bußgelder und Aufsichtsmaßnahmen, die ausschließlich aus eigener Erhebung amtlicher Quellen gespeist wird.
Anfang Oktober 2026 stehen dort gut 3.500 veröffentlichte Fälle aus den Jahren 2017 bis 2026: rund 2.800 mit Geldbuße, gut 600 Maßnahmen ohne Geldbuße wie Verwarnungen und Anordnungen, zusammen knapp sechs Milliarden Euro. Jeder Fall verweist auf das Originaldokument der Behörde, mit Abrufdatum und Umrechnungskurs zum Tag des Bescheids.
Nicht Vollständigkeit, sondern Belegbarkeit
Das Projekt begann am 26. August 2026 mit einem Entwurfspapier, nicht mit Code. Darin steht ein Satz, der alle späteren Entscheidungen geprägt hat: Das Unterscheidungsmerkmal ist nicht Vollständigkeit – die ist bei dieser Quellenlage unerreichbar –, sondern belegte Herkunft und korrekt nachgeführte Rechtskraft.
Der Grund ist ernüchternd. Viele Behörden veröffentlichen nur einen Teil ihrer Entscheidungen, manche gar kein Register. Eine Datenbank, die Vollständigkeit verspricht, verspricht etwas, das sich nicht halten lässt. Was sich halten lässt: Zu jeder Zahl gibt es ein Dokument, und zu jedem Fall ist bekannt, wann zuletzt nachgesehen wurde.
Dazu gehört eine klare Quellenpolitik. Behördliche Entscheidungen sind amtliche Werke und nach § 5 UrhG gemeinfrei. Fremde Sammlungen und fremde Zusammenfassungen sind es nicht. Deshalb übernimmt multabase nichts aus bestehenden Bußgeld-Trackern, und das ist nicht nur eine Absichtserklärung: Der gesamte Abruf läuft über einen einzigen zentralen Baustein, der vor jedem Zugriff die robots.txt auswertet, Wartezeiten je Domain einhält, sich mit Projektname und Kontaktadresse ausweist und eine Sperrliste führt. Ein einzelner Connector kann diese Regeln nicht umgehen, weil er selbst gar nichts abruft.
Eine Regel, die nur im Konzept steht, hält bis zum ersten eiligen Abend. Eine Regel, die im Code an genau einer Stelle durchgesetzt wird, hält auch danach.
40 Connectoren für 40 verschiedene Arten, eine Entscheidung zu veröffentlichen
Jede Datenschutzbehörde veröffentlicht anders. Spanien und Frankreich führen Listen, Italien und Polen bieten eine Suche, Hamburg, Sachsen und Schweden einen Feed, Kroatien ein Register, Luxemburg eine Liste mit angehängten PDFs. Für jede dieser Quellen gibt es einen eigenen Connector – inzwischen 40, vom Europäischen Datenschutzausschuss über die nationalen Behörden von Bulgarien bis Norwegen bis zu allen deutschen Aufsichtsbehörden. Beträge kommen dabei in der Originalwährung an, in Leu, Kronen, Pfund oder Lew, und werden zum Referenzkurs der Europäischen Zentralbank am Tag des Bescheids umgerechnet. Der Kurs wird mit dem Fall gespeichert, nicht bei jedem Seitenaufruf neu berechnet – sonst würde sich ein Bußgeld von 2019 mit jedem Wechselkurs ändern.
Alle Connectoren folgen demselben Ablauf:
- Finden: Der Connector meldet, welche Dokumente es seit einem Stichtag gibt.
- Abrufen und archivieren: Der zentrale Abruf holt das Dokument und legt es unverändert im Archiv ab, benannt nach seinem Inhalts-Hash. Damit lässt sich später beweisen, was die Behörde an diesem Tag veröffentlicht hatte, und eine verbesserte Auswertung kann erneut laufen, ohne die Behörde ein zweites Mal zu belasten.
- Auswerten: Aus dem Dokument entstehen Kandidaten mit Betrag, Datum, Adressat, verletzten Artikeln und Belegstelle.
- Vorlegen: Kandidaten landen in einem Zwischenbereich, nicht in der Datenbank.
- Freigeben: Ein Mensch prüft und gibt frei. Erst dann wird der Fall öffentlich.
Der Stack dahinter ist ein pnpm-Monorepo in TypeScript mit vier Teilen: das Datenmodell mit Drizzle auf PostgreSQL, die Erhebung als Kommandozeilenwerkzeug, die API mit Fastify und die Weboberfläche mit Next.js. API und Oberfläche teilen sich dieselben Zod-Schemata, aus denen auch die OpenAPI-Beschreibung entsteht. Warum sich bei so einem Datenmodell eine relationale Datenbank anbietet, steht in unserem Beitrag zu Datenbankdesign.
Deutschland: Die Fälle stehen in PDF-Berichten
Die größte Lücke lag ausgerechnet vor der Haustür. Die deutschen Aufsichtsbehörden führen kein öffentliches Bußgeldregister. Einzelfälle stehen, oft anonymisiert und ohne genauen Betrag, in den jährlichen Tätigkeitsberichten – PDF-Dokumente mit mehreren hundert Seiten, in denen ein Bußgeld irgendwo zwischen Grundsatzfragen und Beratungsstatistik in einem Absatz erwähnt wird.
Hier arbeitet ein Sprachmodell, wahlweise über die Anthropic-API oder über einen selbst betriebenen Ollama-Server. Die Berichte werden in Ausschnitte von höchstens 80 Seiten geschnitten, das Modell liest die Fälle heraus und muss zu jedem ein wörtliches Zitat mit Seitenangabe liefern. Dann kommt die entscheidende Stelle: Ein Programm sucht dieses Zitat im Text der angegebenen Seiten. Findet es das Zitat nicht, wird der Fall verworfen – gleichgültig, wie plausibel er klingt.
Diese Zitatprüfung ist die harte Schranke gegen erfundene Fälle. Ein Sprachmodell kann einen Betrag falsch lesen oder zwei Absätze vermischen, aber es kann kein Zitat erfinden, das wörtlich im Originaldokument steht. Was die Prüfung übersteht, ist immer noch nur ein Kandidat und geht in dieselbe Freigabe wie alles andere. Geprüft haben wir das Verfahren vorab an drei Berichten aus Brandenburg, Baden-Württemberg und Berlin, deren Fälle von Hand erfasst waren, und die Trefferquote der Auswertung dagegen gemessen.
Auf diesem Weg sind Fälle aus den Berichten der Landesbehörden von 2018 bis 2025 in den Bestand gekommen. Wo immer es ohne Sprachmodell geht, geht es ohne: Die Beträge der italienischen und belgischen Bescheide liest ein regelbasiertes Programm aus dem Entscheidungstenor, bei eingescannten Seiten mit Texterkennung über Tesseract. Regeln sind nachvollziehbar, kosten nichts je Aufruf und irren sich jedes Mal auf dieselbe Weise.
Ein Bußgeld ist nicht endgültig, wenn es verhängt wird
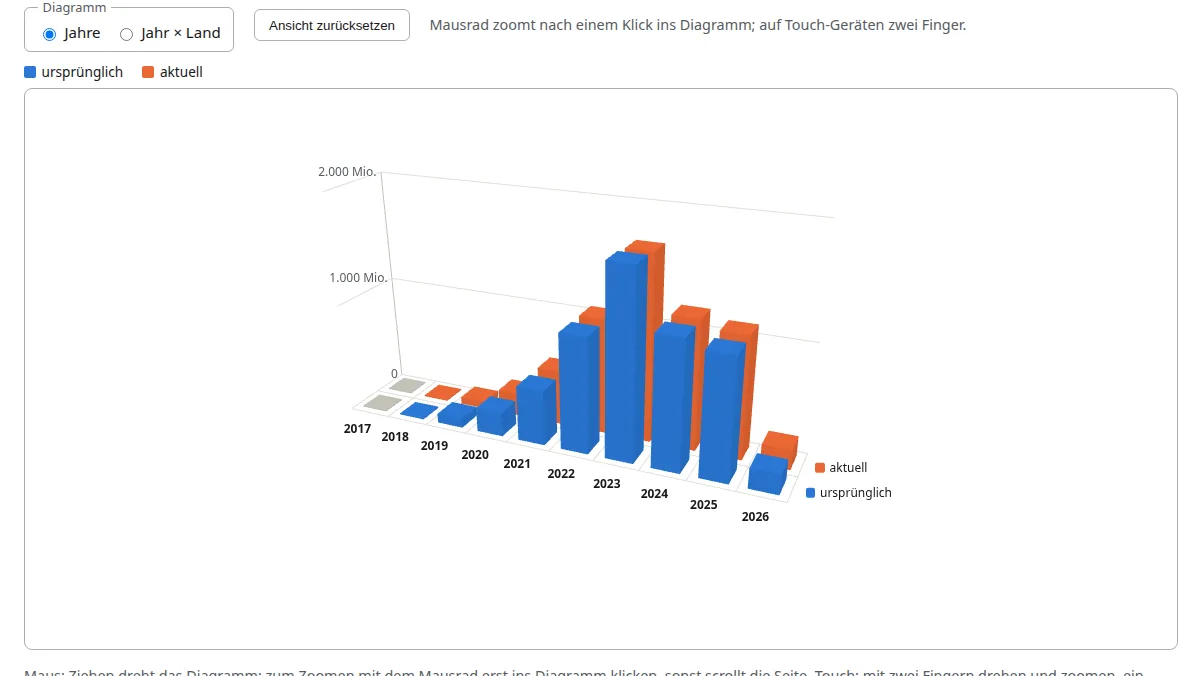
Der zweite Grundsatz betrifft die Zeit nach dem Bescheid. Gerichte ermäßigen, heben auf, selten erhöhen sie. In der Statistik von multabase ist das sichtbar: Für das Jahr 2019 stehen ursprünglich 87,6 Millionen Euro verhängte Bußgelder in der Tabelle, aktuell sind davon 65,2 Millionen übrig. Wer nur die Zahl aus der Pressemitteilung kennt, rechnet mit einem Viertel zu viel.
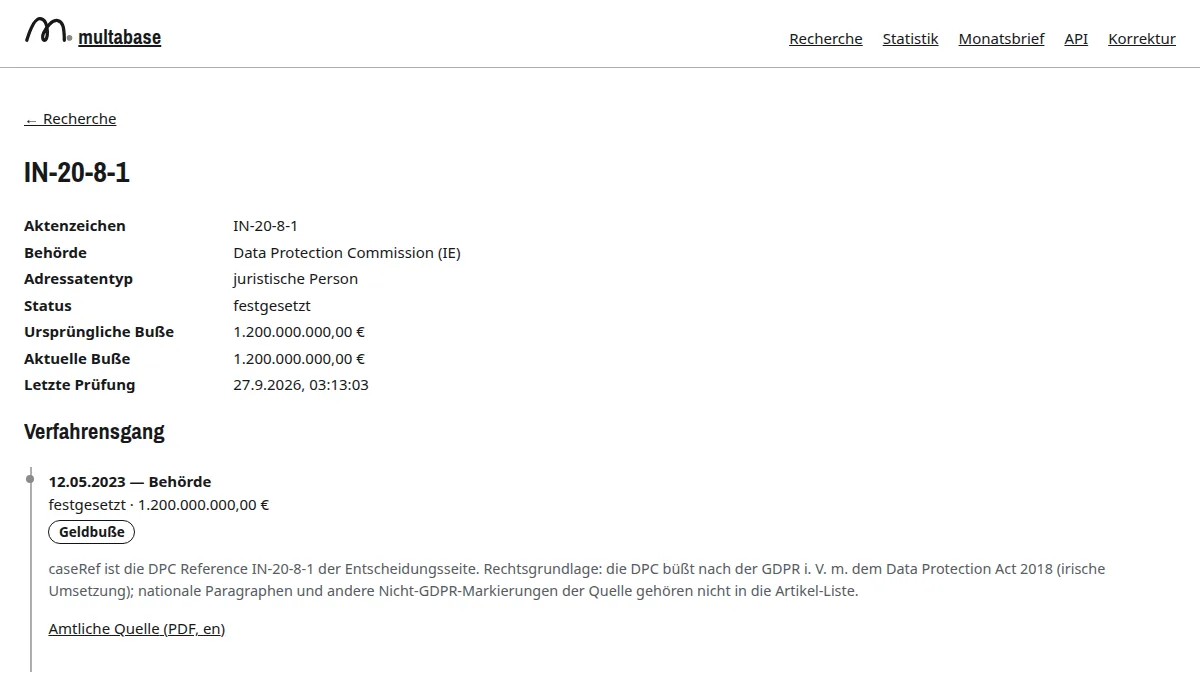
Das Datenmodell trennt deshalb den Fall von seinen Entscheidungen. Ein Fall hat eine Behördenentscheidung und beliebig viele Gerichtsinstanzen, jede mit Datum, Ausgang und eigenem Beleg. Der aktuelle Betrag und der Status werden nie von Hand gesetzt, sondern aus der jüngsten Entscheidung berechnet. Die Fallseite zeigt den gesamten Verfahrensgang und kennzeichnet, wenn der heutige Betrag vom ursprünglichen abweicht.
Drei Mechanismen halten das aktuell:
- Gerichts-Connectoren: Für Österreich und die Niederlande durchsuchen eigene Connectoren die amtlichen Rechtsprechungsdatenbanken nach Urteilen zu Bußgeldbescheiden. Der Ausgang wird nur übernommen, wenn der Urteilsspruch eindeutig ist. Alles andere – Teilaufhebung, Rückverweisung, uneinheitlicher Tenor – meldet der Lauf mit „bitte prüfen".
- Erfassung von Hand mit Beleg: Urteile aus anderen Ländern werden per Tabelle eingepflegt. Auch hier holt das Programm die amtliche Quelle selbst und prüft das Belegzitat wörtlich gegen ihren Text.
- Regelmäßige Nachschau: Jeder veröffentlichte Fall wird spätestens alle 90 Tage erneut geprüft, die höchsten Beträge zuerst. Das Programm ruft die bekannten Belege ab und vergleicht den Inhalt mit dem archivierten Stand. Hat die Behörde ihre Seite geändert, ist das ein Anlass hinzusehen – eine neue Entscheidung entsteht daraus bewusst nicht automatisch.
Zu jeder Prüfung entsteht ein Eintrag, auch wenn sich nichts geändert hat. Nur so lässt sich später sagen „am 27. September geprüft, unverändert" statt „wir wissen es nicht". Auf der Fallseite steht dieses Datum als „Letzte Prüfung".
Was multabase heute kann
- Recherche: Filter nach Land, Behörde, verletztem Artikel, Adressatentyp und Status, dazu eine Suche über Aktenzeichen, Adressaten und Zusammenfassungen.
- Fallseite mit Verfahrensgang: ursprüngliche und aktuelle Buße, alle Instanzen in zeitlicher Folge, zu jeder Entscheidung der Link auf die amtliche Quelle.
- Statistik: Bußgeldsummen je Jahr, getrennt nach ursprünglichem und aktuellem Betrag, als Balkendiagramm oder als drehbare 3D-Ansicht mit three.js, auch aufgeschlüsselt nach Land. Die exakten Beträge stehen immer zusätzlich in einer Tabelle.
- REST-API: Fallliste mit Filtern, Falldetails mit Belegen, Behörden, Artikel und Jahresstatistik als JSON, beschrieben per OpenAPI. Lesen geht ohne Anmeldung mit zehn Anfragen pro Minute. Ein kostenloser Schlüssel hebt die Grenze auf 1.000 Anfragen im Monat; er wird nach Bestätigung der E-Mail-Adresse genau einmal angezeigt und nicht per Mail verschickt.
- Monatsbrief: die neuen Bußgelder und Maßnahmen des Monats, höchstens eine E-Mail im Monat, reiner Text, ohne Zählpixel.
- Korrektur und Beschwerde: ein eigener Kanal für Betroffene und für Hinweise auf Fehler.
Bezahlte API-Stufen mit Exporten und höheren Kontingenten sowie ein Warndienst, der neue Fälle nach Branche, Land und Verstoßart meldet, sind angekündigt, aber noch nicht buchbar. Wer selbst eine Schnittstelle plant, findet die Grundlagen in unserem Beitrag zu Best Practices der API-Entwicklung.
Eine Datenschutz-Datenbank muss selbst Datenschutz können
Eine Sammlung von Rechtsverstößen verarbeitet heikle Daten. Bußgelder treffen nicht nur Konzerne, sondern auch Einzelpersonen – den Vermieter mit der Kamera im Treppenhaus, die Beamtin mit dem unbefugten Abruf.
- Keine Namen natürlicher Personen: Ist der Adressat eine natürliche Person, bleibt das Namensfeld leer. Das ist keine Konvention, sondern eine Bedingung in der Datenbank selbst: Ein Datensatz mit Namen lässt sich gar nicht speichern. Angezeigt wird „Privatperson", die Ortsangabe wird auf das Land vergröbert.
- Freitext nur nach Bestätigung: Beschreibungen zu Fällen gegen Einzelpersonen werden geleert, es sei denn, der Prüfer bestätigt ausdrücklich, dass der Text keine Identifizierung erlaubt.
- Information nach Artikel 14: Weil die Daten nicht bei den Betroffenen erhoben werden, gibt es eine eigene Seite mit der Information nach Artikel 14 DSGVO.
- Sparsame Anmeldung: Monatsbrief und API-Schlüssel laufen über Double-Opt-in. Wer die Löschung verlangt, dessen Schlüssel wird gesperrt und dessen E-Mail-Adresse entfernt.
Die allgemeinen Grundlagen dazu beschreibt unser Beitrag zu DSGVO-konformer Webentwicklung. Und wer wissen will, ob die eigene Website Anlass für einen Eintrag geben könnte: Darum geht es im Beitrag über ScanCompliance.de.
Fehler korrigieren, ohne Spuren zu verwischen
Bei 40 Quellen bleiben Fehler nicht aus. Derselbe Bescheid erscheint im europäischen Register und bei der nationalen Behörde, ein Aktenzeichen enthält einen Tippfehler, ein Betrag wurde falsch gelesen. Dafür gibt es zwei Werkzeuge, und beide folgen denselben Regeln.
Dubletten werden zusammengeführt, nicht gelöscht: Quellen und Belegstellen wandern zum Zielfall, die alte Adresse leitet dauerhaft dorthin um. Widersprechen sich die beiden Einträge bei Betrag, Ausgang oder Rechtskraft, bricht das Programm ab, statt zu raten. Korrekturen an freigegebenen Entscheidungen verlangen eine amtliche Quelle und ein wörtliches Zitat daraus. Jede Änderung landet in einem Protokoll mit Bearbeiter, Zeitpunkt, altem und neuem Wert, Grund und Beleg. Und beide Werkzeuge kennen einen Trockenlauf, der alles in der Datenbank durchrechnet und am Ende zurückrollt – man sieht genau, was geschähe, bevor es geschieht.
Tests, die den Bestand nicht anfassen können
Das Projekt hat in knapp sechs Wochen 320 Commits und über 260 Testdateien angesammelt. Jeder Connector wird gegen gespeicherte Originalseiten der Behörde getestet, nicht gegen das Netz. Die Tests leeren vor jedem Lauf alle Tabellen – was bei einer Datenbank, deren Wert in geprüften Einträgen liegt, eine Gefahr ist. Deshalb weigert sich die Funktion zum Leeren, irgendetwas anzufassen, dessen Datenbankname nicht auf _test endet. Der Riegel greift auch dann, wenn die Verbindungsadresse von außen falsch gesetzt ist. Mehr zum Thema in unserem Beitrag zu Testing-Strategien.
Ausgeliefert wird wie bei unseren anderen Produkten als Docker-Container hinter nginx, mit Blue/Green-Wechsel: Die neue Fassung startet neben der alten, und erst wenn sie läuft, schaltet der Server um.
Was wir aus dem Projekt mitgenommen haben
Erstens: Das Sammeln ist der leichte Teil. Eine Liste von Bußgeldern ist in wenigen Tagen zusammengetragen. Die Arbeit steckt in der Frage, was davon stimmt, was doppelt ist und was heute noch gilt – also in Freigabe, Zusammenführung und Nachschau.
Zweitens: Ein Sprachmodell braucht eine Schranke, die es nicht überreden kann. Die wörtliche Zitatprüfung ist ein schlichter Textvergleich und gerade deshalb verlässlich. Das Modell macht Vorschläge, das Programm prüft den Beleg, der Mensch entscheidet.
Drittens: Ehrlich über Lücken zu sein, ist ein Merkmal und kein Makel. multabase unterscheidet zwischen „laut Quelle keine Geldbuße", „Betrag nicht genannt" und einem Datum, das nur auf das Jahr genau bekannt ist. Eine erfundene Genauigkeit wäre bequemer und für jeden wertlos, der sich auf die Zahl verlassen muss.
Wenn Sie ein ähnliches Vorhaben haben – Daten aus vielen uneinheitlichen Quellen, die verlässlich zusammengeführt und über eine Schnittstelle bereitgestellt werden sollen –, dann ist das die Art von Projekt, die wir in der Webentwicklung umsetzen. Und wenn Sie beruflich mit Datenschutz zu tun haben: Die Recherche auf multabase.com ist frei zugänglich, der Monatsbrief kostenlos.
Lassen Sie uns Ihr Projekt gemeinsam umsetzen
Vereinbaren Sie ein kostenloses Erstgespräch – wir beraten Sie persönlich und unverbindlich.
Kostenloses Erstgespräch vereinbarenVerwandte Artikel
 Entwicklung
TennisSlot.de: Wie aus einem Algorithmus ein Trainingsplaner für Tennisvereine wurde
Jedes Frühjahr sitzt in fast jedem Tennisverein jemand vor einer Tabelle und versucht, Dutzende Spieler auf Trainer, Plätze und Uhrzeiten zu verteilen. TennisSlot.de nimmt diese Arbeit ab: Der Plan entsteht per Knopfdruck, lässt sich per Drag & Drop nachbessern und geht per Klick an alle Spieler. Ein Blick auf Funktionen und Entstehung.
 Security
ScanCompliance.de: Website-Compliance automatisiert und beweissicher prüfen
Google-Fonts-Abmahnungen, Cookie-Banner-Bußgelder, das neue Barrierefreiheitsstärkungsgesetz: Die rechtlichen Anforderungen an Websites wachsen schneller, als Kanzleien sie manuell prüfen können. ScanCompliance.de prüft sie automatisiert – und liefert beweissichere Berichte, auf die man sich verlassen kann.
 Backend
API-Entwicklung: Best Practices für robuste Schnittstellen
Eine gut designte API ist das Rückgrat moderner Webanwendungen. Wir stellen die wichtigsten Best Practices vor, mit denen Sie robuste und wartbare Schnittstellen entwickeln.
 Security
DSGVO-konforme Webentwicklung: Was Entwickler wissen müssen
Die DSGVO stellt konkrete Anforderungen an die Webentwicklung. Wir erklären, welche technischen Maßnahmen Entwickler umsetzen müssen, um datenschutzkonform zu arbeiten.